①や㈱が別の文字になる。環境依存文字(機種依存文字)と、変換で消える文字
文字化け・文字コードのコラム
執筆:松村 誠(植木鉢団 代表)
丸囲みの「①」や、括弧付きの「㈱」。
これらを含む文書を別の環境に渡すと、違う文字に変わったり、消えたりすることがあります。
機種依存文字、あるいは環境依存文字と呼ばれるもので、いまも変換の場面で問題になります。
環境依存文字とは
使う環境によって、表示が変わったり、表示できなかったりする可能性のある文字のことです。
丸囲みの数字、「㈱」のような括弧付きの略字、「㎡」のような単位記号、ローマ数字の「Ⅲ」などが当たります。
Windowsで「まるいち」と入力して変換すると、「①」の候補の横に「環境依存」と出ます。
環境依存文字が、環境によって変わる理由
文字コードは、文字と番号の対応表です。
かつて日本語の環境では、この対応表がメーカーごとに拡張されていました。
同じ番号に、あるメーカーは「①」を割り当て、別のメーカーは違う文字を割り当てる。
そうすると、番号だけが送られた先で、意図と違う文字が表示されます。
現在広く使われているUTF-8では、この重複は整理されています。
それでも問題が残るのは、古い対応表を使う場面がまだあるためです。
同じ「Shift_JIS」でも、入っている文字が違う
Windowsで使われてきたShift_JISは、規格どおりのShift_JISに、メーカーが拡張した文字を足したものです。
CP932やWindows-31Jと呼ばれることもあります。
①や㈱、㎡、はしご高の「髙」などは、この拡張部分に入っています。
そのため、Windowsの日本語環境どうしでやり取りする限りは、①をShift_JISに変換しても残ります。
問題が出るのは、受け取る側が規格どおりのShift_JISとして読む場合です。
拡張部分の文字は、そちらでは別の文字になったり、読めなかったりします。
「Shift_JISで」と指定されたら、Windowsの拡張文字を含めてよいかまで確かめておきます。
変換で落ちる文字がある
UTF-8には収録されていて、Shift_JISには収録されていない文字があります。
- 絵文字
- 一部の漢字(人名や地名で使われる字体)
- 特殊な記号
こうした文字を含むテキストをShift_JISに変換すると、対応する番号が無いため、そのまま持っていけません。
変換の実装によって、疑問符に置き換わったり、その文字だけ消えたりします。
厄介なのは、この脱落が警告なしに起きることです。
変換は成功したように見えて、後から読み返すと文字が欠けている。原文が手元に無ければ、何が消えたのかも分かりません。
変換する前に確認する
Shift_JISへの変換が必要な場面では、事前に次を確認しておくと安全です。
- 絵文字が含まれていないか
- 丸囲み数字や単位記号(㎡、℡など)が含まれていないか
- 人名の漢字に、見慣れない字体が混ざっていないか
含まれている場合、受け取る側の環境によっては、別の文字になったり欠けたりします。
先に別の表記へ置き換えておく(「①」を「(1)」にする、「㎡」を「m2」にする)ほうが、後から気づくより安全です。
MojiRescueでは、変換の前に知らせる
MojiRescueでShift_JIS(Windows日本語)やEUC-JPへ変換するときは、変換先で表せない文字を先に探します。
見つかった場合は、「表現できない文字が ○ 種類(計 ○ 文字)見つかりました」と数と一覧を出し、このまま変換すると「?」に置き換わることを表示します。キャンセルするか、そのまま変換するかを選べます。
探すのはファイル全体です。
※一覧に出すのは100種類までです。種類の多いファイルでは、変換後に検索して確かめてもらえればと思います。
絵文字や「𠮷」(つちよし)は、この一覧に出ます。
①や㈱、㎡、はしご高の「髙」は、Windowsで使われてきた拡張部分も含めて変換するので、一覧には出ません。
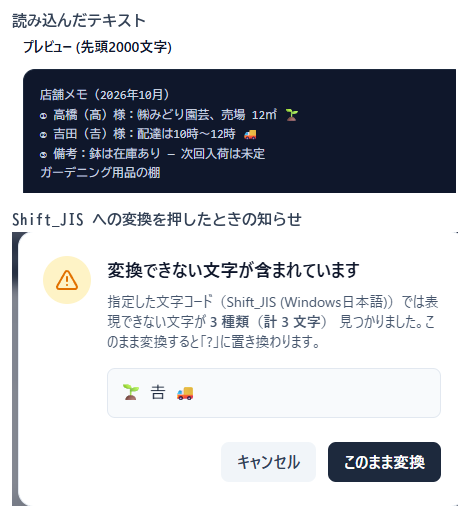
一覧に出さないまま、別の文字に置き換えて書き出すものもあります。
「〜」(波ダッシュ)は「~」(全角チルダ)に、「—」(ダッシュ)は「―」(水平線)にして書き出します。
どちらも、見た目のよく似た記号にUnicodeの文字が2つあり、Windowsの対応表には片方しか入っていないためです。そのまま変換すると「?」になってしまうので、対応表にあるほうへ寄せています。
※変換したファイルをUTF-8に戻しても「~」のままなので、「〜」で検索すると引っかからなくなります。
「ガ」が「カ」と濁点の2文字に分かれているような文字は、変換の前に1文字にまとめてから書き出すので、これも一覧には出ません。
分かれ方と確かめ方は「見た目が同じなのに一致しない文字」のコラムに書いています。
CSVで起きやすい
実務でこの問題に当たりやすいのは、CSVを扱う場面です。
ExcelでCSVを開くために文字コードを変換する。その途中で、担当者名に入っていた「𠮷」や、備考欄の絵文字が落ちる。
表そのものは開けるので、欠落に気づかないまま作業が進みます。
件数が多いほど、目視での発見は難しくなります。
変換の前後で文字数を比べる、変換後に問題の文字で検索してみる。そういった確認を挟んでおくと、後から気づく事態を減らせます。
そもそも変換しない選択
変換先をUTF-8にできるなら、それが一番確実です。
Shift_JISが必要になるのは、受け取る側のソフトがそれしか読めない場合です。
先に相手の要件を確認しておくと、無駄な変換と、それに伴う文字の欠落を避けられます。